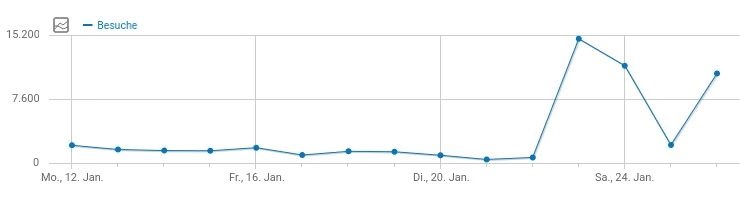
Meine „Besucherzahlen“ sind um 3.058% gegenüber dem Vorjahr gestiegen – und das im August. Zeitgleich sind über 15.000 Verbindungen parallel geöffnet. Doch das liegt nicht an plötzlich viral gegangenen Inhalten – sondern Bots, die massenhaft Besuche erzeugen. Das ist nicht grundsätzlich neu. Doch verschiedene Faktoren haben die Lage 2026 derart eskalieren lassen, dass ein stark überdimensionierter physischer Server mit 8 Kernen sowie reichlich RAM in die Knie gezwungen wurde. Sämtliche Dienste sind nur noch mit starker Verzögerung erreichbar, teilweise gar nicht.
Dies zeigt, in welche bedenkliche Richtung sich das Internet bzw. Web entwickelt. Und welche neuen Probleme inzwischen zum Alltag gehören. Bemerkenswert ist dabei die Geschwindigkeit, welche ich an den eigenen Projekten beobachten konnte. Hinzu kommt die Altlast eines Forensystems, welche das Problem mutmaßlich noch weiter verschlimmert hat.
„KI“-Bots sind da: Die Ruhe vor der „KI“-Welle
Anfang Februar fiel mir bei routinemäßigen Wartungsarbeiten auf, dass sowohl Auslastung als auch Datenverkehr auf dem U-Labs Server deutlich über dem gewöhnlichen Spektrum lagen. Meine anschließende erste Überprüfung von Stichproben zeigte: Die Zugriffe auf das Forum sind um Faktor 5 bis 10 (je nach Tag) signifikant gestiegen. Vor allem die großen Konzerne aus der „KI“-Branche riefen automatisiert alle URLs auf, die sie finden konnten: Themen, Foren, Profile – das volle Programm.
Crawler sind nicht neu. Google und weitere Suchmaschinen rufen seit Jahrzehnten regelmäßig Webseiten auf, um dortigen Links zu folgen. Hinzu kommen diverse Bots für andere Zwecke. Neu war: Sie schienen in großem Stil echte Webbrowser fern zu steuern. Das lädt automatisch zahlreiche Abhängigkeiten wie CSS, JavaScript, Bilder & Co, wodurch sich Anfragen und Datenverkehr erhöhen. Obwohl vieles davon für Bots uninteressant ist. Schließlich werten sie primär den Inhalt aus, statt etwa dem per CSS festgelegten Aussehen der Seite.
Vorerst entschied ich, das Ganze weiter zu beobachten – ohne aktives Blockieren oder andere Eingriffe. U-Labs liegt auf einem physischen Server, der für die übliche Last erheblich überdimensioniert ist. Negative Auswirkungen auf die dort betriebenen Projekte gab es zu diesem Zeitpunkt daher trotz der spürbar erhöhten Last keine. Ich machte mir Gedanken, wie zukünftig am sinnvollsten damit umgegangen werden sollte – und wie sich dies auf andere Seiten negativ auswirkt, die lediglich einen Webspace oder kleinen virtuellen Server zur Verfügung haben.
Plötzlich sind wir langsam & dann zeitweise offline
Doch nach kurzer Zeit wurden die Bots deutlich aggressiver: Statt 5-10x mehr Aufrufe registrierte ich plötzlich bis zu 198x mehr. Und das nicht etwa gleichmäßig über den Tag verteilt – sondern mit starker Konzentration am Nachmittag sowie in den Abendstunden. Als akute Maßnahme erhöhte ich die Zahl der PHP-Prozesse im Forum. Das verbesserte die längeren Ladezeiten sowie vermied kurzzeitigen Timeouts. Es dauerte jedoch erneut nicht lange, bis die Anzahl der Anfragen 398x so hoch war, wie üblich – ein neuer Rekord, der den Prozessor auf 8 Kernen zu 100% auslastete. Das Forum wurde unbenutzbar.
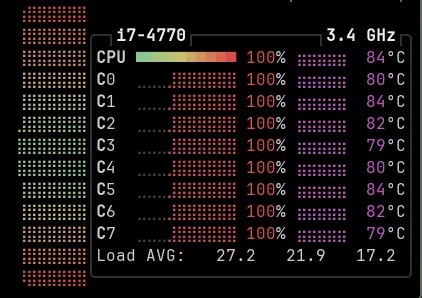
Daher folgten striktere Limits pro IP. Damit war die Community zwar wieder nutzbar und die Auslastung sank erheblich. Dennoch war offensichtlich: Der Server bediente weitaus mehr automatisierter Bot-Anfragen, als echter Menschen. Alleine PHP bediente bis zu 16 Anfragen pro Sekunde – trotz Limits, die immer wieder von verschiedenen IPs überschritten wurden.
Die Bots werden immer mehr & aggressiver
Anfangs stammten die vielen Anfragen von einer noch relativ überschaubaren Menge an IP-Adressen. Immer wieder kamen zwar neue hinzu, doch das Ganze war beherrschbar. Bis es einige Zeit später auf eine ganz neue Stufe eskalierte: Eine große Welle von verschiedenen IP-Adressen rief zeitgleich mit wenig bis überhaupt keiner Pause ständig neue URLs auf. Es waren derart viele, dass viele Anfragen gar nicht bis zum Nginx/PHP-Container des Forums durchkamen. Stattdessen beanspruchte der Reverse Proxy teilweise die gesamten 8 Kerne (!) für die TLS-Terminierung. Damit war nicht mehr nur das Forum betroffen, sondern sämtliche Webseiten auf dem Server.
Um die Dimensionen zu verdeutlichen: Bei der kürzlichen Spitze im August kamen in nur 10 Sekunden HTTPS-Anfragen von rund 11.700 verschiedenen IP-Adressen. Diese öffneten zudem teils mehrere Verbindungen gleichzeitig: Über 22.500 TCP-SYNs auf Port 443. Das entspricht über 2.260 Verbindungsversuchen pro Sekunde! Hier stieß schlicht die Hardware an ihre Grenzen. Der Server ist dafür überhaupt nicht ausgelegt, da die Zahl der gleichzeitigen legitimen Anfragen weit darunter liegt.
Und das sollte noch nicht die Spitze gewesen sein. Später eskalierte der Traffic auf rund 41.000 SYNs innerhalb von 10s, somit knapp 4.100 Verbindungsversuche – jede Sekunde.
Verdächtig: Nur HTTPS-Datenverkehr betroffen
Bemerkenswert ist, dass dies kein generischer SYN-Flood war, um die Leitungskapazität oder andere begrenzte Ressourcen offensichtlich bewusst zu überlasten. Dies kennt man als eine Form von DDoS-Angriffen, bei denen das Ziel alleine darin besteht. Blockierte ich allerdings testweise IPv4-Zugriffe auf Port 80 und 443 (also HTTP und HTTPS) auf Firewall-Ebene vollständig, brach die Serverlast auf nahezu null ein. Nach dem Aufheben der Blockade war das System sofort wieder stark ausgelastet. IPv6 war dagegen nicht betroffen.
Beim Auswerten der Zugriffsprotokolle fiel zudem auf: Die Zugriffe wirkten alles andere als menschlich. Sie verteilten sich auffällig gleichmäßig auf verschiedene Foren sowie deren Themen. Es ist äußerst unwahrscheinlich, dass echte Menschen das gesamte Forum in diesem Ausmaß systematisch „durch klicken“. Insbesondere nachdem nahezu alle IP-Adressen aus dem Ausland stammten, oft von weit entfernten Ländern.
Einzelne Fälle mögen hier noch realistisch erscheinen – etwa, weil jemand aus dem deutschsprachigen Raum dort Urlaub macht. Oder im Zweifel auch mal eine Geo-IP Zuordnung falsch ist. Insbesondere in Grenznähe durchaus vorstellbar. Doch diese Dimensionen sind ein klarer Indikator für ferngesteuerte Bots, die systematisch Inhalte des Forums indexieren oder anderweitig verarbeiten.
Der Flaschenhals
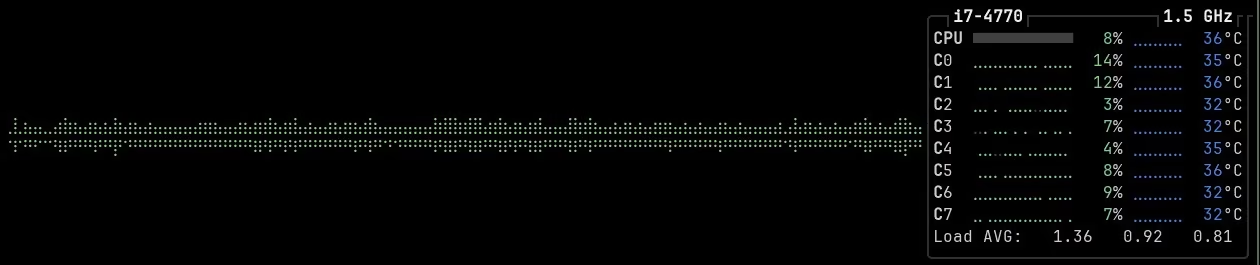
Mit bis zu 380 Mbit/s ist das Netzwerk zwar deutlich stärker ausgelastet gewesen, als üblich. Doch noch längst nicht am Limit für eine Gigabit-Verbindung. Der Flaschenhals war hierbei die CPU: Bei der anfänglich noch „moderaten“ Überlastung von Rund 2.300 Verbindungen pro Sekunde belegte PHP mit ca 400% CPU-Last bereits die Hälfte der Kerne. Traefik kam direkt danach mit etwa 249%. Die konkrete Auslastung variierte mit der Zeit. Das Ergebnis blieb gleich: Der Prozessor ist mit 90-100% am Anschlag.
Als sich die Verbindungsversuche fast verdoppelten, änderte sich die Verteilung. Nun lastete Traefik nahezu die gesamte CPU aus. Viele Anfragen kamen gar nicht mehr bis zum PHP-Backend, weil Traefik die TLS-Terminierung für mehrere tausend Verbindungen pro Sekunde durchführen musste. Hier hat sich die Load auf bis zu 88 erhöht.
Was nicht mehr half
Ich wollte möglichst wenige echte Besucher fälschlicherweise aussperren. Daher war mein erster Ansatz ein Skript, welches das Zugriffsprotokoll nach IPs mit auffällig vielen Anfragen in kurzer Zeit durchsucht. Um diese von Leuten abzugrenzen, die sich schneller durch die Foren klicken, erfolgt zusätzlich eine Länderzuordnung per lokaler Geo-IP Datenbank. Darin ist Deutschland zusammen mit den umliegenden EU-Ländern sowie den USA (wegen Google, OpenAI & Co.) ausgeschlossen.
Als anfangs nur wenige IPs den Server mit Anfragen fluteten, war das eine brauchbare Übergangslösung. Doch bei tausenden IPs hatte es keine Chance mehr: Viele IPs landeten aufgrund der Überlastung des Reverse Proxy erst verzögert oder teils gar nicht mehr im Access-Log. Es muss berücksichtigt werden, dass eine eingehende HTTPS-Verbindung neben der TLS-Terminierung eine weitere im Backend auslöst.
Um dies greifbarer zu machen: Bei der Analyse eines Access-Logs stammten mehr als 168.700 Anfragen von rund 87.700 IP-Adressen. Im Schnitt führte jede IP gerade einmal 1,9 Anfragen durch. Auch Stichproben der tausenden SYNs zeigten: Selbst die häufigste IP hatte lediglich vier Treffer. Es handelt sich also um einen sehr verteilten Angriff, bei dem IP-Limits kaum etwas bewirken.
Nun greifen Residential-Proxies an?
Besonders auffällig ist die Analyse der Herkunft. Ich habe Geo-IP Abfragen auf Auszüge der Access-Logs mit mehreren tausend Zeilen durchgeführt: Zuvor kam die klare Mehrheit aus den USA – u.a. etwa von Servern, die Microsoft Azure gehören. Diese Konzentration ist verschwunden. Stattdessen verteilen sie sich quer über den Globus: Indien, Vietnam, Kenia, Argentinien, Chile, Brasilien, Kolumbien, Irak und viele weitere.
Außerdem ist auffällig, dass ein großer Teil davon mit hoher Wahrscheinlichkeit zu Internetanbietern für Privatkunden gehört. Aus einer Stichprobe von 25 IPs sind 19 wohl von privaten Endkunden. 5 gehören zu ISPs, bei denen die Nutzung unklar ist. Nur einer lässt sich zweifelsfrei einem kommerziellen Hosting-Anbieter zuordnen. Derart viele private IPs aus Ländern, die gar nicht zur Zielgruppe von U-Labs gehören, sind starke Indikatoren für eine Art von Residential-Proxies.
Die neue Strategie
Zurück zu meinem Problem, welches durch diese mutmaßlichen Proxies entstanden ist. Bei derartiger Masse konnte nur der umgekehrte Ansatz helfen – und zwar auf Firewall-Ebene: Über eine lokale Geo-IP Datenbank habe ich die Netze in der EU ermitteln können, um damit ein IP set zu befüllen. Das ist eine Datenstruktur in Linux, die wahlweise das effiziente Speichern größerer Mengen von IP-Adressen, Subnetzen, Ports oder MAC-Adressen ermöglicht. Sie lassen sich mit iptables-Regeln verknüpfen: Beispielsweise allen IPs im Set X den Zugriff auf Port 80/443 erlauben oder verweigern.
Das ist wesentlich performanter, als unzählige einzelne Firewall-Regeln anzulegen. Dort müsste jedes Datenpaket auf alle Regeln hin geprüft werden – eine schlechte Idee. In meinen Tests haben selbst IP sets mit hunderttausenden IP-Adressen (beim anfänglichen Sperren) die Leistung nicht spürbar beeinträchtigt.
Doch es gibt Herausforderungen
Der aktuelle Ansatz ist wesentlich einfacher und verzichtet auf Analysen der Zugriffsprotokolle. Allerdings hat er auch einen Nachteil: IPs mit falscher Zuordnung in der Geo-IP Datenbank werden abgewiesen. Das ist insbesondere mit älteren LTS-Betriebssystemen ein Problem. Ubuntu 22.04 LTS von 2023 enthält das geoip-database Paket von Dezember 2019. In knapp 6 Jahren kann sich einiges ändern. Beispielsweise die mobile IP meines Smartphones, welche dort im EU-Ausland zugewiesen war.
Das Problem lässt sich deutlich reduzieren, in dem man die Datenbank aus dem Deb-Paket von Ubuntu 26.10 extrahiert und über den Parameter -f übergibt. Sie ist von Anfang August und damit derzeit erst gut zwei Wochen alt. Dennoch sind solche Zuordnungen nie 100% akkurat. Außerdem müssen diese hinsichtlich Änderungen in der Zukunft aktuell gehalten werden.
Residential-Proxies: Gezielter Missbrauch für („KI“-)Scraping
Scraping bezeichnet das automatisierte Sammeln von Daten aus fremden Internetseiten: Eine Software besucht dafür Webseiten, oft massenhaft und speichert die gewünschten Informationen in einer Datenbank. So funktionieren beispielsweise Preisvergleichsportale. Sie rufen die Produktseiten aller bekannten Shops auf, um den Preis sowie weitere Informationen (Versandkosten, Lagerstatus etc) zu ermitteln. Aus den gesammelten Daten entsteht das Ranking der günstigsten Anbieter.
Nicht immer werden Nutzer vorher gefragt, bevor andere ihren Internetanschluss als Residential-Proxy verwenden. Kriminelle nutzen Sicherheitsmängel, um alle möglichen Geräte als Proxy zu missbrauchen. Und das im großen Stil – man spricht von einem Botnetz. Solche gekaperten Systeme wurden früher hauptsächlich für DDoS-Angriffe missbraucht, um Webseiten lahm zu legen. Mittlerweile kommen sie zunehmend zur Umgehung von Scraping-Limits zum Einsatz.
Erst im Juni 2026 entdeckten Sicherheitsforscher ein solches Botnetz aus Millionen Smarten TVs. Etwa 1,35 Millionen IP-Adressen aus 223 Ländercodes sammelten Daten von der Plattform „Arab Reporters for Investigative Journalism“. Auch im deutschsprachigen Raum ist das Problem längst real – bei abuse.ch waren es 135.000 einzigartige IPs, die etwa 1.500 Anfragen pro Sekunde sendeten.1
Wenn LG & Samsung ihre Kunden ans Messer liefern
Üblicherweise sind Sicherheitsmängel die Grundlage: Dadurch installieren Kriminelle unbemerkt die Software für einen Residential-Proxy (oder andere Schadsoftware). Ab diesem Zeitpunkt haben sie die Kontrolle über ihr Gerät endgültig verloren. Doch mit LG & Samsung ergriffen zwei große Hersteller lange keine Maßnahmen zum Schutz ihrer Kunden.
Eine Analyse zeigte, wie groß das Problem ist: Über 42% der Erweiterungen in LGs webOS Store enthalten eine Bibliothek, wodurch die TVs zu Proxys werden. Bei Samsung (Tizen) sind es immerhin 26,5%.2 Erst als diese Ergebnisse sich durch die Medien verbreiteten, kündigte LG Gegenmaßnahmen an.
In der Falle: Was kann getan werden?
Bei der Lösungsfindung hatte ich darüber nachgedacht, „KI“-Crawler auf allen erdenklichen Wegen zu blockieren. Das klingt nach einer einfachen Lösung, ist jedoch deutlich schwieriger. Ähnlich wie Suchmaschinen die robots.txt berücksichtigen oder eben ignorieren können, gibt es keinen garantierten Ausschluss. Insbesondere bei bereits aggressiv auftretenden Crawlern ist wenig Kooperation zu erwarten. Sicherlich ließe sich das entschärfen, indem bekannte IPs in der Firewall blockiert werden. Ebenso auffällige mit vielen Anfragen in kürzerer Zeit.
Doch das grundlegende Problem beginnt bereits ganz woanders: LLMs, allen voran ChatGPT, sind bereits die bislang am schnellsten wachsende Technologie der Geschichte. Trotz fehlendem Verständnis und sehr hohen Fehlerquoten lösen Chatbots die klassische Websuche zunehmend ab. Für Seitenbetreiber ein großes Problem: Die Sprachmodelle bedienen sich fremder Inhalte, während die Klickraten dort bereits erheblich einbrechen. Damit verschärft sich das Einnahmenproblem des überwiegend von Werbung finanzierten Internets weiter, bislang ohne wirkliche Lösung.
Kleinere und mittlere Seitenbetreiber stehen damit de facto vor der Wahl: Entweder überlassen sie „KI“-Modellen ihre Inhalte kostenfrei – dafür bekommen sie noch weniger Aufrufe, als vorher. Tendenz sinkend. Oder man versucht, „KI“ auszuschließen. Noch schwieriger wird es, wenn selbst das Tolerieren solcher Bots auf erheblich überdimensionierten Servern zum Ausfall führt.